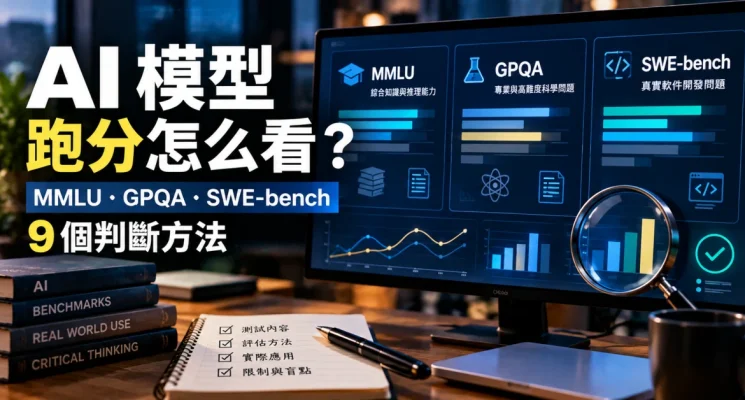
AI 模型跑分 怎么看?MMLU、GPQA 与 SWE-bench 的 9 个判断方法
技能
每次有新的 AI 模型发布,宣传资料里总会出现一排分数:MMLU 90%、GPQA 80%、SWE-bench 70%……数字看起来很客观,但对普通使用者来说,真正的问题是:分数高,是否代表写中文文章、核对采访资料、整理 Excel 或处理客户邮件也一定更好? AI 模型跑分 应该怎么看呢?
答案是不一定。AI 模型跑分(AI benchmark score)可以帮助我们比较特定测试里的表现,却不能直接等同于「综合智力」「可靠程度」或「适合你的工作」。要读懂排行榜,先了解它测了什么、怎么测,以及哪些工作根本没有被测到。
一、AI Benchmark 是什么?先分清测试题与真实工作
Benchmark(基准测试)是把一批任务、题目、评分规则和运行条件固定下来,让不同模型在相对可比较的情况下接受测试。好处是能追踪技术进步,也能找出模型在知识、推理、编码或多模态任务上的长短处。
不过,考试题目终究只是现实任务的一个切面。一个模型能答对困难的科学选择题,不代表它能够准确核对马来西亚公司的新闻稿;一个模型能修复程序错误,也不代表它擅长把一篇中文采访整理成自然、可信的长文。斯坦福大学的 HELM 评测项目因此强调,模型评估应尽量覆盖不同情境与指标,而非只看单一准确率。
二、先认识三种经常出现的跑分
1. MMLU:跨学科知识与推理
MMLU(Massive Multitask Language Understanding)以多个学科的选择题衡量知识和推理,涵盖科学、人文、社会科学及专业领域,共 57 个学科。它比较适合回答「模型能否处理广泛知识题」,不适合单凭一项分数判断文章是否有采访深度、翻译是否地道,或会不会捏造来源。可参阅 MMLU 原始研究。
2. GPQA:难度更高的专业科学问答
GPQA(Graduate-Level Google-Proof Q&A)原始研究使用由领域专家撰写的高难度生物、物理与化学选择题,目的在于测试较复杂的专业知识与推理。原始论文说明数据集共有 448 道题目。它有助于观察困难科学题的表现,却不等于模型已能独立从事科研,更不能代替专家审查。参考 GPQA 原始论文。
3. SWE-bench:能不能处理真实软件问题
SWE-bench 使用真实软件仓库和 GitHub issue,要求模型或代理产生修复补丁,再依照测试环境判断问题是否解决。常见的 SWE-bench Verified 是经人工筛选的 500 道可解决任务子集。它比一般选择题更接近软件开发流程,但成绩也会受到工具、运行环境、尝试次数与评估设置影响。可参考 SWE-bench 官方说明与排行榜。
三、看 AI 模型跑分,至少检查这 9 件事
1. 测试对象是模型、聊天产品,还是整套 Agent?
同一个基础模型接上网页搜索、代码执行器、外部工具或专用提示词后,表现可能明显不同。先问清楚分数是模型直接回答,还是包含工具调用、自动重试和代理编排。若比较对象不一样,排行榜就不能简单画上等号。
2. 指标是准确率、解决率,还是人工偏好?
MMLU 的选择题准确率、SWE-bench 的问题解决率,以及人工比较回答偏好的胜率,不是同一种单位。即使数字都是百分比,也不能把「80% GPQA」和「80% SWE-bench」直接比较谁比较厉害。
3. 是否使用同一版本、同一题集与同一测试设置?
测试日期、模型版本、题集版本、是否提供示例题(few-shot)、是否允许搜索或代码工具,都可能改变结果。某份旧排行榜上的领先模型,未必仍是今天最适合的选择;比较时应记录具体版本和评测日期。
4. 是否披露推理成本、时间与尝试次数?
一个模型用很长时间、很多次尝试才解决问题,与另一个模型在几秒内给出足够准确的结果,对真实工作有不同价值。除了分数,也要看延迟、API 成本、token 使用量及成功率是否稳定。斯坦福 HELM 方法说明特别把效率、稳健性等维度纳入整体评估思路。
5. 题目有没有被模型在训练时见过?
这叫作测试资料污染(benchmark contamination)。公开题目可能进入训练语料,模型因此记住答案,而不是在陌生题目上展现同样能力。不过,资料重叠不一定都会带来相同幅度的分数提升,不能一发现重叠就直接判定所有成绩无效。有关影响差异,可参阅 EMNLP 2024 的开放式污染分析研究。
6. 只看平均分,会不会掩盖你最在意的弱点?
一个模型可能英语数学表现优秀,中文长文编辑却不自然;另一个模型总体分数略低,却能稳定处理多语术语。平均分不会告诉你哪种错误最常发生,也不会显示它是否容易漏掉资料、误解指示或胡乱引用。先把自己的任务列出来,再找对应评测。
7. 分数差距有多大?有没有误差范围?
两款模型相差 0.5 个百分点,可能不足以支持「明显领先」的宣传。应检查题量、重复测试、统计不确定性与报告方式。尤其是题量有限、设置容易改变的测试,小幅领先不代表每一次实际使用都比较好。
8. 是否只有开发者自己提供成绩?
开发者公布的成绩可以参考,但更理想的是同时查看可复现的方法、公开评测脚本、第三方复核及失败案例。独立评测也并非绝对没有偏差:题目选择、评分规则与评测者偏好一样值得检查。
9. 能否在自己的真实工作里重复得到好结果?
最后一关是实测。对于内容创作者,真正重要的可能是事实核查、长文结构、中文语感、品牌术语与资料来源;对网站经营者,则可能是表格核对、HTML 质量、WordPress 内容结构和任务可靠性。这些都不能靠一个通用跑分完全判断。
四、普通使用者怎样设计一套小型 AI 模型实测?
不必建立实验室,也不需要一次测试几十个模型。选择你每周确实会做的 5 至 10 项工作,用同一批材料、同一套指示和明确的评分表来比较。以下是一种适合中文编辑、翻译和网站经营者的方式。
- 选任务:例如把英文新闻稿翻译成中文、从官方来源核对五项事实、整理一张销售表、改写冗长段落、提出有证据的标题。
- 固定输入:不同模型使用相同原始材料;记录是否开启搜索、上传文件或调用其他工具。
- 先写评分标准:准确性 40%、完整性 25%、中文可读性 20%、效率 15%,只是示例;可依业务调整。
- 记录错误:除了给分,更要标出错译数字、虚构引文、漏列项目、错误 HTML 等具体问题。
- 多次测试:尽量在不同日期或多次运行,避免单次运气左右结论。
- 计算总成本:把人工校对和返工时间算进去;最便宜或最快的模型,不一定是总体成本最低的。
例如,一款模型 30 秒写完初稿,却要花 20 分钟核对事实;另一款模型慢一点,但引用更完整、返工更少。后者对编辑室可能更实用。有关如何回到第一手来源查证,可配合站内的《用 ChatGPT 查资料,怎样判断来源可信?》执行。
五、模型选择不只是「谁的榜单第一」
阅读模型介绍时,可以先把知识、推理、软件开发、中文编辑、可靠性、速度、价格当成不同项目。需要处理复杂研究时,还要比较工具是否能找到和引用可靠资料,而不只是回答速度。站内《ChatGPT Deep Research 怎么用?和 Search 有什么不同》讨论了研究任务与普通搜索的差异;如果正在比较模型版本,也可参考《GPT-6 是什么?》,但产品定位仍须以当下官方说明为准。
另外,公开排行榜会持续变化。本文不列出「2026 年最强模型前十名」,因为没有统一、永远有效的答案;相较于短期名次,理解评测方法更有长期价值。
FAQ:AI 模型跑分常见问题
AI 模型跑分越高,就越不会出现幻觉吗?
不能这样推论。知识题正确率与真实任务的事实可靠性相关,但不是同一指标。是否编造引用、会不会承认不知道、能否依据来源纠错,都需要另外测试。
MMLU、GPQA、SWE-bench 哪个最重要?
没有统一答案。MMLU 偏向跨学科知识,GPQA 偏向高难度科学问答,SWE-bench 偏向软件修复。选与你的工作最接近的评测,比争论哪一个分数最大更有意义。
排行榜为什么会出现互相矛盾的名次?
不同榜单使用的任务、模型版本、工具权限、采样设置、评分方式及更新日期可能不同。先检查规则,再看名次。
中文使用者能直接相信英文 Benchmark 吗?
可以把它当参考,但不能取代中文测试。若工作涉及简体/繁体转换、马来西亚语境、品牌术语或中文编辑,应该自行准备代表性材料做实测。
模型宣传写「超越人类专家」,应该怎么理解?
先看「人类专家」是谁、完成什么题目、在什么条件下比较。某个特定题集上的表现超过某组人类参与者,不等于模型在现实世界全面超越所有专业人员。
结语:把跑分当地图,不要当目的地
AI Benchmark 的价值,在于帮助我们用更一致的方法理解模型能力,而不是替所有使用者决定最佳工具。看模型跑分时,记住九个问题:测什么、怎么算、条件是否一致、成本多少、题目是否污染、弱点在哪里、差距是否显著、能否独立复核,以及你的实际任务能否受益。
对于真正每天用 AI 工作的人,最好的模型不是排行榜上永远第一名的模型,而是能够在可接受成本内稳定完成任务、让你容易发现并纠正错误的模型。
资料核对日期:2026 年 10 月 16 日。本文介绍基准测试原理与判断方法,不代表任何品牌或模型的即时排名。
感谢阅读。
支持本站
如果这篇文章对你有帮助,欢迎支持我们的创作。



Leave a comment