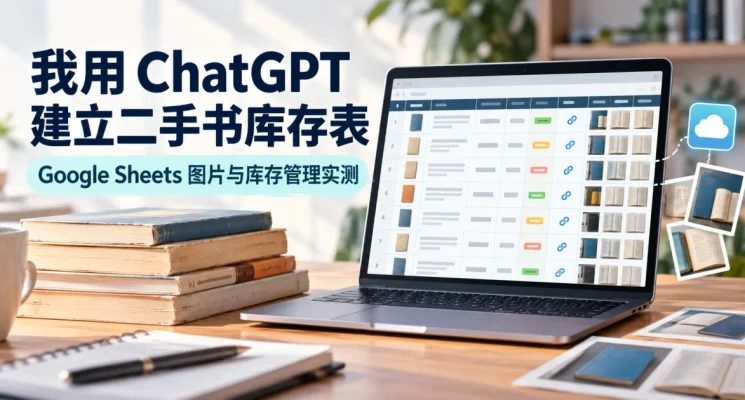
我 用 ChatGPT 建立二手书库存表 :Google Sheets 图片与库存记录的真实踩坑
技能
2026 年 9 月底,我打算 用 ChatGPT 建立二手书库存表 ,开始整理手上的二手书 。起初以为只要把书名、作者和售价放进表格就够了,真正做下去才发现,二手书和一般新品库存不同:同一本书可能有不同版本、封面、装帧和保存状况,甚至没有完整 ISBN;图片又牵涉到 Google Drive 的分享权限与 Google Sheets 的显示方式。
我把 ChatGPT 当作协助设计与检查表格的工具,实际在 Google Sheets 建立了「二手书库存管理」。这篇不是假设案例,也不是声称 AI 一次就把库存系统做好,而是记录我在 2026 年 9 月 28 至 29 日实际处理过的字段、图片链接、公式、错误和仍未解决的问题。若你也想用 ChatGPT 建立二手书库存表,可以从这些步骤开始。
一、为什么不直接做一张「书名+售价」的表?
二手书的关键不是单纯计算有多少本,而是每一本实体书是否能被准确辨认。同一本作品的不同出版社、再版年份和品相,价格可能完全不同。我因此把库存记录设计成「每本书一笔可追踪资料」,而不是只靠书名当识别码。
目前表格中可以看到 The Wind in the Willows、Microsoft MS-DOS User’s Guide、The Mortal Coil and Other Stories、Making Rocking Horses 等实际录入的书籍。它们横跨儿童文学、复古电脑、文学短篇和手工制作,正好说明为什么分类、版本与品相不能省略。
二、先决定字段:SKU、ISBN、版本、品相和状态分开
我的 Google Sheets「库存」工作表现有字段包括 SKU、封面、书名、作者、插画、ISBN-10、ISBN-13、类别、语言、出版社、版本/年份、装帧、品相、库存状态、数量、入货价、售价、存放位置、封面图片、版权页图片、封底图片和备注。
我采用 BK-0001 这样的 SKU 编号。SKU 是自己管理库存的唯一标识,不等于 ISBN;ISBN 用来识别出版版本,但某些旧书可能没有、缺失或无法确认。此时不能为了填满字段而让 AI 编造 ISBN,留空比填错更可靠。
品相也不能只有「好」与「不好」。例如「明显泛黄、封面污渍、边角磨损、书脊折痕」这类描述,比一个笼统等级更能让未来买家判断实物。ChatGPT 可以帮助整理文字,却不能代替我看实物。
三、已售书不能删除:库存和销售历史是两回事
我一开始就要求:书卖出去之后,记录仍要保留,只把库存状态改成「已售」,并记录成交日期、成交价等资料。原因很简单——删除已售记录,会连带丢失进货成本、过去定价与销售表现。
目前这张表已经有「库存状态」和「数量」等基本字段;售出日期、实际成交价和利润则属于后续可继续扩展的销售记录。这里要区分已经在表内的字段与未来想增加的功能,不能把计划写成已经完成的系统。
若之后转成销售网站,我会继续保留 SKU、商品描述、图片来源与状态等稳定字段,方便导出 CSV 或对接电商系统。但截至这次整理,表格仍是库存管理工具,不是已经上线的二手书商城。
四、图片比想象中麻烦:封面、版权页、封底分开存
我把图片放到 Google Drive,并在表格里分开记录封面、版权页和封底图片链接。这样以后重新核对 ISBN、出版社、印刷年份、装帧或书况时,不必重新翻找实体书。照片也能为未来的商品页面提供素材。
这里我踩过一个重要的坑:Google Drive 的「任何知道链接的人可查看」不等于 Google Sheets 的 IMAGE() 一定能直接显示缩图。Google 官方 IMAGE 函数说明明确指出,函数不能使用托管在 drive.google.com 的 URL;它也不会自动把单元格尺寸调整到图片大小。
我当时尝试用分享链接拆出图片 ID,再组合成另一种地址,表格里确实留下了类似 =IMAGE(X2,1) 的公式,以及辅助列的链接处理公式。但这不是通用、稳定的 Google 官方图片托管方案,不能只看公式存在,就宣布所有缩图已经显示成功。
五、W5 的旧链接和 AC 辅助列,教我不能只相信「已经修好」
实际核对时,我发现 W5 曾经用了旧链接,要求重新更正;也追问过 AC 栏为什么出现数据。回看表格,图片链接的处理涉及固定前缀、自动拼接地址、拆分文件链接等辅助列,例如 =JOIN("",W5,AC5) 与 =SPLIT(S5,"/")。这些中间步骤虽然能解释图片 ID 从哪里来,但也让表格变得不够直观。
这次经验让我确定:ChatGPT 可以替我建议公式、整理栏位、指出可能错误,却不应该只回复「好了」。我需要实际打开目标单元格,核对原始链接、生成地址、公式结果与画面是否一致;特别是图片链接一旦换过,旧 ID 很容易继续留在其他列。
对新手而言,较简单的办法是使用 Google Sheets 的「插入 → 图片 → 插入单元格内」功能;这是 Google 官方支持的图片插入方式。若未来要批量导出图片 URL 给网站使用,则应另建可靠的图片存储和链接规范,不要把表格里的缩图当作唯一原档。
六、封面图片大小与行高:整齐比「自动放大」重要
我还研究过 B5 封面缩图如何配合书本大小,以及是否把行高统一为 160 像素。这个细节看似很小,但书本有横式、直式、不同长宽比,若每一列都随图片变化,浏览库存会变得很累。
Google 的 IMAGE(url,1) 会在单元格内保持图片比例,IMAGE(url,2) 则会拉伸图片,可能令书封变形;IMAGE(url,4,height,width) 可指定尺寸,但不会自动修改列宽与行高。对我的用途,统一行高、保持封面比例、把大图留在原始链接,比较适合长期管理。
这属于版面设计取舍,不代表每个缩图链接都已通过测试。最终还是要以表格实际显示效果为准。
七、公开图片链接前,先理解分享权限
为了让链接可供查看,我测试过 Google Drive 的分享权限。但「任何知道链接的人」不等于完全没有隐私风险:持有链接的人可能继续转发,而文件拥有者信息在某些分享场景也可能可见。Google 的 官方分享说明列出了 Viewer、Commenter、Editor 等权限。
如果库存表只是私人管理,原则上不需要把整张表公开。即使商品照片未来要公开,也应分清「公开商品图片」与「内部成本、库存位置、备注」的权限。关于上传文件与敏感资料,我之前也写过把资料交给 ChatGPT 前应检查的隐私原则。
八、我真正学到的不是公式,而是让 AI 有可检查的工作流程
回顾这次整理,ChatGPT 最有用的部分,是协助我把零散需求变成固定字段、统一命名、检查链接、修正表格问题,并且把未来扩充为二手书网站的可能性提前考虑进去。实际录入的书籍、照片和品相仍需要我逐一确认。
如果今天重新开始,我会按这个顺序操作:
- 先选一小批真实书籍,确定每本书的 SKU 和基础字段。
- 核对书名、作者、ISBN、出版社、版本与品相,缺资料就留空。
- 分别保存封面、版权页、封底原始图片链接,不急着做缩图公式。
- 先测试一张图片能否稳定显示,再批量套用;失败就记录原因。
- 为「在库/已售」建立一致状态规则,已售记录不删除。
- 检查成本、售价、数量与存放位置,避免混淆采购价和成交价。
- 抽查不同类别的书,确认每一列都对得上实物。
- 最后才考虑批量导入、自动化与电商网站对接。
若需要让 AI 协助整理原始 Excel、PDF 或 CSV,可以参考我之前的ChatGPT 文件上传与资料分析实用方法。如果未来要把书籍图片放进商品网页,图片说明与无障碍处理也可以参考WordPress 图片 Alt Text 的写法。这样以来,你也可以和我一样, 用 ChatGPT 建立二手书库存表 。
FAQ:用 ChatGPT 管理二手书库存,常见的三个问题
ChatGPT 能自动识别所有 ISBN 吗?
不能保证。它可以帮助整理从照片或文字提取的信息,但 ISBN、出版社、印次等仍要对照版权页和可靠书目资料。无法确认时不要猜。
Google Drive 公开链接可以直接放进 IMAGE 公式吗?
不能把这当作可靠的通用方法。Google 官方说明 IMAGE() 不支持托管在 drive.google.com 的 URL。可以考虑插入单元格图片,或改用符合函数要求的可访问图片来源。
表格做好后,可以直接变成二手书网站吗?
不能一键保证。SKU、商品名称、价格、库存状态、描述和图片来源等字段可作为迁移基础,但还需要商品页面、库存同步、订单、付款与售后流程。我的表格目前仍处于库存管理与图片处理阶段。
小结:让 ChatGPT 帮忙,但把验证留在自己手上
这次做二手书库存,我最深的感受是:AI 很擅长把「我想记录二手书」变成一套结构,却不会自动知道哪一个链接是旧的、哪一张照片对应哪本书,也不能只凭一句「已经完成」就替代验收。有编号、有原始资料、有状态记录、可以逐项核对,才是这张库存表真正有价值的地方。
感谢阅读。
支持本站
如果这篇文章对你有帮助,欢迎支持我们的创作。



Leave a comment