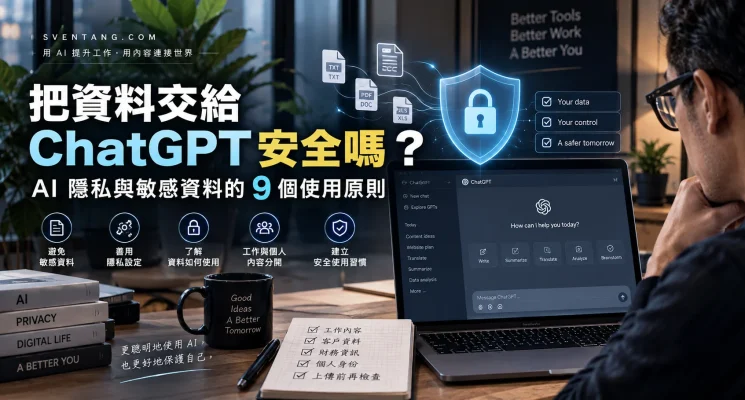
把资料交给 ChatGPT 隐私 安全吗?AI 隐私与敏感资料的 9 个使用原则
技能
我们越来越习惯把资料直接交给 AI:履历、合约、会议记录、Excel、客户名单、公司文件,甚至私人对话。ChatGPT 能够帮忙整理、翻译、分析和找重点,但「上传得进去」不代表「什么都适合上传」。但, ChatGPT 隐私 如何运作?
AI 隐私真正要处理的,不只是模型会不会训练你的资料,而是整条资料链:你输入了什么、账号怎样保存记录、有没有连接第三方 App、文件里有没有隐藏的个人资料,以及 AI 在调用网页或外部工具时可能接触哪些系统。
以下 9 个原则,适合一般个人用户、内容工作者与小型团队,在使用生成式 AI 前做最基本的资料风险判断。
1. 先问:这份资料如果外泄,我会介意吗?
这是最简单也最有效的第一关。身份证号码、银行账号、密码、API Key、未公开财务数据、客户个人资料、医疗记录、内部合约与商业机密,都不应该因为「AI 可以分析」就原封不动贴进去。
OWASP 的生成式 AI 安全指南把个人身份资料、财务资料、健康记录、机密商业数据、安全凭证与法律文件列为典型敏感信息。最安全的习惯仍然是数据最小化:AI 不需要知道的,就不要给。
2. 能匿名化,就不要上传真实身份
如果任务只是分析格式、语气或数据结构,很多时候根本不需要真实姓名。例如把「陈先生、012-xxxxxxx、公司 A」改成「客户 A、电话已删除、公司 X」。
履历也可以先移除住址、身份证号码、私人电话号码;销售表可以只保留商品、数量、金额,而不是连客户姓名和联络资料一起上传。
这和ChatGPT 文件上传怎么用?PDF、Excel 与资料分析的 8 个实用方法可以配合使用:文件分析的重点是保留任务需要的数据结构,而不是把整份原始资料毫无筛选地交出去。
3. 个人 ChatGPT 与商业产品的数据政策不要混为一谈
不同产品的数据处理规则可能不同。OpenAI 目前说明,个人服务的用户可以在 Data Controls 关闭「Improve the model for everyone」,关闭后新的对话不会用于训练模型;Temporary Chat 不出现在聊天记录,也不会用于改善模型。
商业产品则有不同承诺。OpenAI 的企业隐私说明指出,ChatGPT Business、Enterprise、Edu、Healthcare、Teachers 与 API 平台的业务数据默认不会用于训练模型。
因此,公司内部使用 AI 时,不应只问员工「有没有 ChatGPT」,还要确认使用的是哪一种账号、组织有什么政策,以及哪些资料获准进入系统。
4. Temporary Chat 有用,但不是「隐身模式」的同义词
Temporary Chat 适合不希望内容进入聊天历史或 Memory 的情况。OpenAI 说明 Temporary Chat 不会用于训练模型,并会依其保留政策处理。
但使用者仍然应该遵守同一个原则:敏感资料能不上传就不上传。隐私设置是降低风险的一层保护,不应该成为上传密码、完整客户数据库或机密文件的理由。
5. 上传 PDF、Excel 前,先检查隐藏资料
文件的风险不只在你看到的文字。Excel 可能有隐藏工作表、备注与额外栏位;PDF 可能包含作者资料、批注或未预期的页面;Word 文件也可能带有修订记录。
上传前最好另存一份「给 AI 使用」的副本,只留下分析所需内容。尤其处理公司资料时,不要为了让 AI 看其中一张表,就直接上传整个年度工作簿。
6. 连接 App、网页和 Agent 后,风险模型会改变
单纯聊天与让 AI 连接外部系统不是同一件事。连接云端文件、邮件、网站或其他 App 后,AI 能处理的资料更多,也出现新的权限与提示注入风险。
OpenAI 在 2026 年介绍 Lockdown Mode 时特别指出,网页与外部连接功能会增加 prompt injection 导致资料被意外传给第三方的风险,因此高安全需求模式会限制部分联网、连接器与下载能力。
这也是为什么AI Agent 是什么?它和 Chatbot、自动化、MCP 有什么不同?里谈到的「工具权限」非常重要:Agent 能做得越多,权限设计就越不能随便。
7. API Key、密码与登入凭证永远不要当普通文字处理
如果你要 AI 帮忙检查代码,可以用 YOUR_API_KEY、DB_PASSWORD 之类的占位符,而不是把真实凭证贴进对话。
一旦真实密钥已经贴到不该出现的地方,正确处理方式通常不是「把那条聊天删掉就算了」,而是撤销旧凭证并产生新凭证。
8. AI 输出也可能泄露资料
隐私不是只有「输入端」。OWASP 把 Sensitive Information Disclosure 列为 LLM 应用的重要风险之一,因为敏感信息也可能经由输出被暴露。
例如让 AI 根据内部会议记录写一篇公开文章时,它可能把原本只作为背景的数字、姓名或未公开计划写进成稿。发布前必须重新检查输出,而不是只检查提示词。
这与AI 事实核查的 7 个步骤其实是同一个编辑原则:AI 产生的是待审核内容,不是自动获得发布资格的内容。
9. 建立自己的「红、黄、绿」资料规则
个人与小团队不一定需要复杂的 AI Governance 文件,可以先用三层分类:
- 绿色:公开资料、已经发布的文章、无个人身份的数据,可正常使用。
- 黄色:内部工作文件、履历、未公开草稿、客户资料,需要先删除身份信息或确认权限。
- 红色:密码、API Key、完整身份证资料、银行资料、高度敏感医疗信息、受保密协议保护的机密内容,原则上不要输入一般 AI 对话。
这个分类的好处,是不用每次都从零判断。团队成员看到红色资料,就知道必须停止并换其他处理方式。
一个实际可用的上传前检查表
- AI 完成任务真的需要整份资料吗?
- 可以删除姓名、电话、电邮、地址和身份证号码吗?
- 有没有密码、Token、API Key 或登入资料?
- 文件有没有隐藏 Sheet、批注、修订或额外页面?
- 资料是否属于客户、公司或第三方,而不是我个人所有?
- 我使用的是个人 ChatGPT、商业工作区还是 API?
- 是否连接了外部 App 或网站?
- 输出之后是否还会有人进行人工检查?
FAQ
关闭模型训练后,就可以上传任何机密资料吗?
不应该这样理解。关闭训练解决的是资料是否用于模型改善的其中一个环节,并不等于所有资料治理、账号安全、权限与第三方风险同时消失。
Temporary Chat 会进入 Memory 吗?
OpenAI 目前说明 Temporary Chat 不会建立 Memory,也不会出现在一般聊天历史中。
公司文件适合用个人 ChatGPT 处理吗?
应先看公司的 AI 与资料政策。公司如果已经提供获批准的商业 AI 工作区,应优先按照组织规定使用,而不是自行把内部资料搬到个人账号。
小结:AI 隐私的核心不是「完全不用」,而是少给不必要的数据
生成式 AI 越方便,我们越容易把「复制贴上」当成没有成本的动作。但资料一旦进入新的系统,就多了一层处理关系。
实际使用时不必因此害怕 AI。更好的习惯是:先删掉不需要的身份信息,只提供完成任务所需的最少资料,理解自己使用的产品与账号政策,并在 AI 输出准备离开私人工作区之前再检查一次。
参考资料: OpenAI Consumer Privacy、OpenAI Privacy Policy、OpenAI Enterprise Privacy、OpenAI Lockdown Mode、OWASP Top 10 for LLM Applications。
感谢阅读。
支持本站
如果这篇文章对你有帮助,欢迎支持我们的创作。



Leave a comment